
在企业智能产品研发中,在创建特定业务场景的训练数据来对模型进行训练时,数据集样本的多样性对模型的能力和泛化性具有较强的影响。但如何量化一个数据集中的样本多样性呢?
本文将介绍如何使用Vendi Score来量化数据集的多样性,在具体的产品研发实践中,该指标可较好地实现数据集样本多样性的量化。
Vendi Score简介
Vendi Score 是由 Dan Friedman 等人在 2023 年提出的一种专门用于评估机器学习数据集多样性的定量指标。
该指标的取值介于 1 和 N(数据集总样本数)之间,值越大,说明数据集中样本的多样性越高,反之越小。其值大致等于数据集中“有效独立样本”的数量。
我们用一个 “水果筐”来解释:
- 假设你有一个装了 100 个水果的筐。
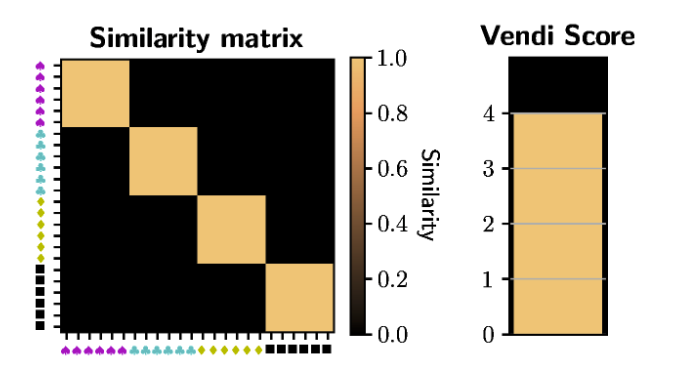
- 如果里面全是苹果,虽然数量是 100,但水果类型只有 1种。此时 Vendi Score ≈ 1。
- 如果里面有 50 个苹果和 50 个香蕉,水果类型是2。此时 Vendi Score ≈ 2。
- 如果里面有 100 个各不相同的水果(苹果、香蕉、橘子、葡萄、榴莲…),没有重复。此时 Vendi Score = 100。
Vendi Score计算
给定一个数据集,它包含了N个样本,Vendi Score的计算步骤如下:
步骤1:样本向量化
选择一个合适的 Embedding 模型,将数据集中的N个样本转化为高维向量。
假设向量维度的d, 则可以获取到一个N*d的二维矩阵。
步骤2:构建相似度矩阵
基于步骤1获取的N*d矩阵,分别计算样本之间的相似矩阵。例如可计算样本之间的余弦相似度来衡量样本之间的相似性。
最终可获取到一个N*N的相似度矩阵。
步骤3:特征值分解
对步骤2的相似度矩阵进行特征值分解,得到一组特征值 λ1,λ2,…,λN。
核心原理:相似度矩阵的特征值代表了数据在不同“主成分”上的区分度或信息量。如果数据样本间存在强相关性或高度同质(矩阵呈现低秩特性),能量就会集中在少数几个(甚至一个)特征值上;如果样本间差异显著且相互独立(矩阵接近单位阵或随机矩阵),能量就会均匀分散在所有特征值上。
步骤4:特征值归一化
对于第三步获取到的特征值,通过λi/N来对每个特征值进行归一化获得pi。
注意:在步骤2中获取的相似度矩阵中,由于主对角线元素每个元素值为1,则主对角线元素之和为N,因此在步骤3获取的特征值之和也为N.
步骤5:计算Vendi Score
使用如下公式来获取最终的Vendi Score的值。
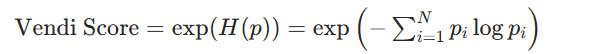
到此时我们可以获取到一个数据集中样本多样性的定量指标。
如果分数越高,则这个数据集的多样性高,否则低。
Vendi Score使用注意事项
在生产中使用该指标需注意:
- Vendi Score的分值和数据样本的规模有关。例如一个样本1000的数据集和样本10000的数据集,不能直接比较两者之间的多样性大小。
- Vendi Score在计算时涉及到两个N*d矩阵的乘法,同时涉及到特征值的计算,可能需要较大的内存和时间,尤其是对于大样本的数据集来说更是如此。